普通人给机器人喂数据,质量隐私成难题,众包数采是好生意吗?
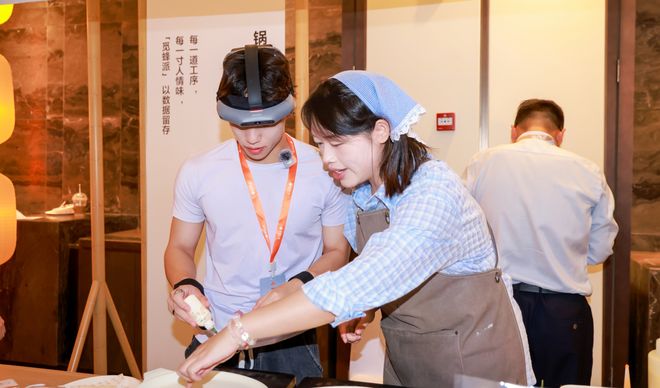
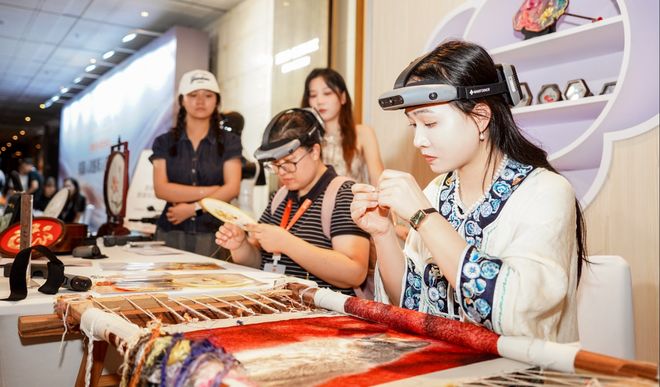
9月23日,上海一场发布会,觅蜂科技抛出重磅炸弹,首个物理AI数据众包平台“觅蜂派”正式上线。这事儿说白了,就是把数据采集的活儿,从企业专属任务,摊到了普通老百姓头上。用户下载App,领个任务,戴上专用设备,在超市、仓库、家里干点活,按有效时长拿钱。物理AI的数据生产,正式迈入“全民数采”时代。数据经过清洗分级,直接喂给具身模型,帮机器人在现实世界干活。
可问题来了,让普通人当机器人的老师,靠谱吗?质量参差不齐,隐私边界模糊,还得砸重金搞硬件,这买卖到底划不划算?发布会上,糕点师现场指导体验者,场面热闹,但背后的账,得细算。
先看好处,众包确实便宜,覆盖面广。美国Figure公司早试过类似路子。今年8月,他们推出Index项目,让用户拍第一视角视频,擦桌子、叠衣服、切菜,上传就有钱拿。Figure的实验数据挺亮眼,在30套陌生住宅里,靠这套预训练数据,零样本成功率从9%飙到56%。这说明,众包数据真有潜力。
这种模式的优势很直观。数据采集不再靠集中雇佣,而是变成分布式社会协作。用户不用特意抽时间,顺手在生活或工作中完成,还能赚点外快。觅蜂派官方说,平台覆盖22大类场景,超5000个任务,涉及5万个真实环境。内测一个月,注册用户2万,提交了1.3万份采集任务。数字看着不小,但质疑声也没停。
采集者是普通人,质量能控住吗?觅蜂科技CEO姚卯青回应,数据不会百分百进模型,但损耗不大。结算时用自动化手段剔除无效部分,比如手不在画面、休息、动作不规范、重复操作。他说,结算后超95%的数据能用得上。数据质量分层管理,不同模型在不同训练阶段,吃不同档次的料,贴上标签尽量留着。隐私方面,平台搞了敏感内容识别、人脸脱敏、实名验证、电子签约、授权留存那一套,还发了《具身智能数据安全行动倡议》。但众包场景复杂,这套机制够不够用,还得看实践。
为啥非得走众包这条路?因为数据需求太大了。过去三年,具身智能从开发转向部署,业界共识是,要实现通用人工智能,数据得从百万小时扩到亿级。可具身模型没大语言模型那种海量文本语料,抓杯子、拧瓶盖、折衣服,这些动作压根没有现成的大规模数据可用。以前行业靠真机遥操,人手柄或VR操控机器人示范,速度慢,还受制于设备数量和场地,成本高得吓人。
姚卯青直言,百万小时早就不够用了,不少公司已到这个量级,必须找新增长点。现在最缺的不是数据总量,而是场景丰富度。质量是基础,但百万小时积累下来,这块已经相对成熟,接下来拼的是场景多样性。他举例,叠衣服数据泛滥了,大家更需要专业的,比如修水管、修车。众包更灵活,能钻进这些细分场景,比雇专人省钱省事儿。数据量越大,模型越聪明,人工占比越低,自动化程度越高。
但别以为众包是轻松生意。姚卯青说,设备生产、人员结算、云端存储计算,全是重投入。想应对1000万小时数据,得砸几亿元固定资产。短期靠补贴拉规模可以,长期看用户活跃度和留存率,还是未知数。发布会上,刺绣师戴着设备工作,画面温馨,但背后是硬邦邦的成本压力。
数采公司越来越多,但还没跑出稳定赚钱的模式。数据显示,过去一年全国新增集中式数采中心106家,84家在运营,平均每月约7.3个新项目启动,大多还没形成商业闭环。怎么做到规模化盈利?姚卯青强调“运营能力”,包括快速培养训练师和拓展场景,优化成本,提升效率,还有扛得住前期资金压力。行业有共性需求,场景要真实、要丰富,不能在一个地方反复采;还要高空间精度,从2D视频里提取六维信息,业内已有共识标准。
客户需求变化很快。姚卯青透露,去年上半年大家聊一万小时,去年底有人到20万小时,今年普遍提百万小时,实际接触的客户已经在要千万小时。AI进入新阶段,必须在物理世界做闭环决策,客户要的就是真实世界的闭环场景数据。头部客户的核心诉求,是“越快越好、越多越好、越丰富越多样越好”,成本排后面,但质量仍是底线,专业性要求极高。
未来怎么走?姚卯青判断,行业必然整合。数采赛道需要“六边形战士”,技术强、产品领先,供应链管理、生产能力、成本控制、质量标准都得按消费电子级别来建,还得重资产投算力存储。这场游戏,拼的不只是创意,更是综合实力和耐心。